EM
Eli McGarvie
Data Engineer Salary UK
over 3 years ago
Savoir-être professionnels
Déplacements Déplacements : Jamais Zone départementale
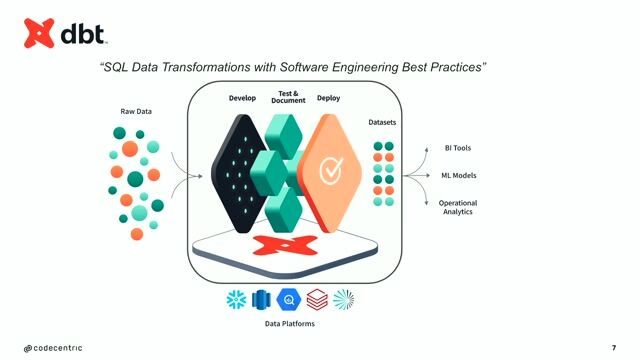
Contexte de la mission : Dans le cadre du développement et de l’évolution d’une plateforme Data Cloud, nous recherchons un Data Engineer GCP pour intervenir sur la conception, le développement et l’industrialisation de pipelines de données à grande échelle. Missions principales : Concevoir, développer et maintenir des pipelines de données batch et/ou streaming. Développer les traitements de données avec Python / PySpark et SQL. Réaliser les transformations et la modélisation des données avec dbt. Exploiter les services GCP : BigQuery, Dataproc, Cloud Storage, Pub/Sub, Composer/Airflow. Optimiser les traitements Spark et les performances des requêtes BigQuery. Industrialiser et automatiser les déploiements via les processus CI/CD. Mettre en place les contrôles de qualité, fiabilité et monitoring des données. Participer à la conception et à l’évolution de l’architecture Data. Collaborer avec les Data Analysts, Data Scientists et équipes métiers. Compétences recherchées : GCP, PySpark, Python, SQL, dbt, BigQuery, Dataproc, Cloud Storage, Airflow/Composer, Git et CI/CD. Profil recherché : Data Engineer confirmé disposant d’une expérience significative sur des environnements GCP et Big Data, avec une très bonne maîtrise de PySpark, SQL et dbt. Le consultant devra être autonome, à l’aise sur des problématiques d’industrialisation et capable d’intervenir sur des volumes de données importants.
This job is hosted externally. Click below to view the full posting and apply.
Talks and stories from around this role — technically off-topic, practically not.