World Congress 2023 • Aug 11, 2023

In-Memory Computing - The Big Picture

Markus Kett

What if you could completely bypass traditional databases? Discover how in-memory computing eliminates object-relational mapping bottlenecks, achieving microsecond query latency and slashing cloud costs by 99%.

Pause
Mute Enter Fullscreen
#1 about 6 min

Critical factors driving modern application performance requirements

Modern applications demand high performance, low data storage costs, and simple technical implementations.

#2 about 4 min

Analyzing speed differences between memory and database queries

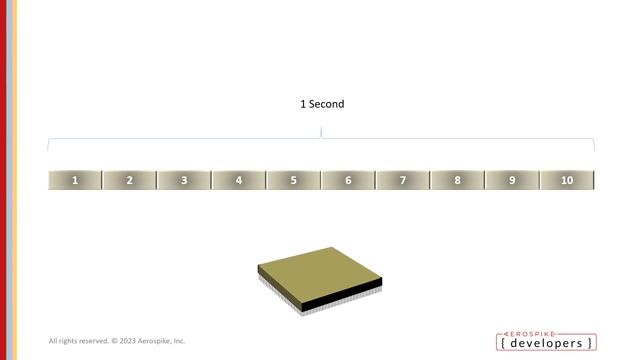
Executing code in memory provides extreme speed advantages compared to the high latency of database access.

#3 about 4 min

Understanding the object-relational impedance mismatch in traditional databases

Storing complex object graphs within relational database tables creates deep architectural incompatibilities.

#4 about 4 min

Evaluating NoSQL databases and data conversion bottlenecks

Despite specialized data structures, non-relational databases still impose heavy performance penalties through object generation overhead.

#5 about 3 min

Implementing distributed caches to reduce relational database load

Extracting data into local or clustered cache environments avoids severe disk IO penalties but adds system complexity.

#6 about 3 min

Comparing distributed caches with in-memory data grids

In-memory data grids build upon distributed cache architecture by allowing organizations to distribute computational algorithms entirely in memory.

#7 about 4 min

Identifying mapping overheads within in-memory database clusters

Because in-memory database nodes run on separate architectures, their overall speed is still constrained by data conversion mappings.

#8 about 5 min

Eliminating database mapping via system prevalence and blob storage

Storing application object structures directly into scalable cloud blob services prevents classical storage latency entirely.

#9 about 3 min

Simplifying enterprise architecture with database-less data processing

Leveraging memory replication directly against binary stores removes both clustering and mapping overheads for significant cloud savings.

Matching moments

3:16 min

Q&A on database vendor lock-in and alternative architectural choices

George Asafev ¡ World Congress 2023

3:25 min

Slashing IT infrastructure costs by adopting memory persistence

Markus Kett Markus Kett ¡ World Congress 2022

2:36 min

Modern application stacks and real-time data requirements

Tim Faulkes ¡ LIVE

4:14 min

Recognizing architectural drivers pushing event streaming system adoption

Mary Grygleski Mary Grygleski ¡ LIVE

5:13 min

The object-relational impedance mismatch in standard database programming

Markus Kett Markus Kett ¡ World Congress 2022

2:31 min

Accelerating data processing via resilient in-memory computing strategies

Markus Kett Markus Kett ¡ World Congress 2022

Upcoming sessions on this topic

Open session

How We Cut Our API's p99 Latency from Minutes to Under a Second

  • Deepak Agrawal

    Atlassian

    Principal Software Engineer

Open session

Architecting Trusted AI: Coupling Multi-Agent Systems with dbt Semantic Store for Zero-Hallucination

  • Pushkar Mishra

    J.P. Morgan

    Senior Vice President

Open session

Multi-Cloud Isn't a Project. It's a Side Effect.

  • Antonio Mendoza PĂŠrez

    Temporal Technologies

    Staff Developer Success Engineer

  • Gaurav Thadani

    Temporal

    Staff Developer Success Engineer

Open session

Building World-Aware Physical AI with Agent Memory and Context Graphs

  • Vasundhara Shukla

    Neo4j

    Developer Advocate

  • Zaid Zaim

    Neo4j

    Developer Advocate | Microsoft AI MVP

Open session

React Under Fire: Rendering Performance for Streaming Agent UIs

  • Abhirupa Mitra

    Slack

    Senior Member of Technical Staff

Open session

Java is Coming for Python’s Lunch: The Rise of JVM AI Agents

  • Frederik Pietzko

    Jetbrains

    Developer Advocate