World Congress 2026 Europe - Virtual Stage Jul 3, 2026 Session details

Why LLMs Need Observability and How to Do It

Rahul Gupta

Traditional dashboards lie because a healthy HTTP 200 means nothing if your LLM hallucinates. Learn how to build true AI observability and measure actual output quality.

Pause
Mute Enter Fullscreen
#1 about 3 min

Addressing the gap between prototypes and production

Production usage introduces unpredicted user inputs that deteriorate reliable response quality.

#2 about 2 min

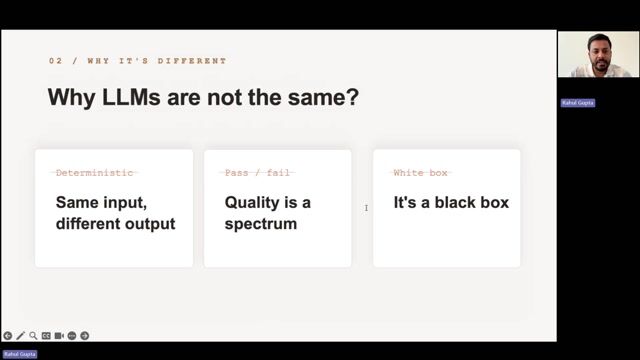
Comparing non-deterministic models to traditional software mechanics

Generative interfaces lack basic deterministic responses and simple binary success mechanisms for straightforward debugging.

#3 about 3 min

Relying on deceptive aggregate health dashboard metrics

Traditional monitoring captures application uptime while completely missing contextually inaccurate outputs displayed to end users.

#4 about 4 min

Recognizing five invisible failure modes of LLMs

Applications silently falter due to generated hallucinations, outdated retrieval documents, quality drift, and latency increases.

#5 about 3 min

Structuring observability for generative model requests

Accurate system monitoring requires recording the entire context environment wrapping model inputs and exact outputs.

#6 about 2 min

Breaking down execution operations into individual trace spans

Segmenting user interactions explains how single requests map into embeddings and required vector search actions.

#7 about 3 min

Selecting crucial operational signals to log during execution

Capturing prompt combinations, retrieval assignment scores, model parameters, and consumed tokens directly guides analytical debugging.

#8 about 2 min

Debugging faulty user interactions using aggregate trace metrics

Examining dips within aggregate quality scoring pinpoints distinct execution failures triggered by outdated retrieval context.

#9 about 5 min

Measuring operational quality with quantitative evaluation datasets

Comparing generated outputs against structured golden datasets standardizes assessment techniques utilizing matched and modeled metrics.

#10 about 3 min

Automating continuous systemic AI response improvement loops

Iteratively observing and experimenting against standard benchmarks establishes vital safety thresholds prior to deploying changes.

#11 about 2 min

Tracing observability across complex multi-step generative architectures

Branching architectural designs need continual measurement covering related embeddings, autonomous agents, and isolated chained operations.

#12 about 2 min

Instrumenting application pipelines utilizing software tracing libraries

Implementing simple library decorators creates automated span measurements isolating precise functional execution durations across programs.

#13 about 2 min

Validating dataset iterations using continuous qualitative user feedback

Aggregating direct manual annotations and inferred application usage patterns continually builds accurate system evaluation datasets.

#14 about 3 min

Distributing AI response quality as a shared organizational responsibility

Safeguarding semantic execution accuracy relies upon strategic cooperation covering engineering branches, specific domain experts, and staff.

#15 about 2 min

Confirming output correctness for responsible generative AI deployment

Prioritizing verifiable contextual accuracy over generalized application uptime reporting continually prevents unforeseen user experience deterioration.

Matching moments

2:36 min

Addressing AI observability and cost transparency with Langfuse

Hellmar Becker Hellmar Becker · World Congress 2026 Europe

1:05 min

Implementing monitoring and observability for AI software deployments

Alejandro Saucedo Alejandro Saucedo · World Congress 2025

1:55 min

Identifying and fixing over-engineered AI calls through observability

diabhey diabhey · World Congress 2025

1:50 min

Managing observability using natural language AI agents

Alex Laubscher Alex Laubscher +3 · World Congress 2025

3:26 min

Introducing LLMs as judges for automated testing

Sebastian Messingfeld Sebastian Messingfeld · World Congress 2026 Europe

3:53 min

Evaluating and observing large language model performance at scale

Krzysztof Cieślak Krzysztof Cieślak · World Congress 2024

Upcoming sessions on this topic

Open session

World Congress 2026 North America

September 24, 2026 · 13:30–14:00

Stage 9

Understanding LLM Architectures: Inside the Design of Modern Models

Jofia Jose Prakash

Director - AI & Governance at Humanity + AI, Inc

Jofia Jose Prakash
Open session

World Congress 2026 North America

September 24, 2026 · 11:40–12:10

Stage 4

Taming Rogue Agents: Observability-Driven Evaluation for Production Reliability

Anagha Rumade, Anjana Umapathy, Apoorva Jaiswal

Anagha Rumade
Anjana Umapathy
Apoorva Jaiswal
Open session

World Congress 2026 North America

September 25, 2026 · 11:40–12:10

Stage 9

You Can’t Re-Run Sunlight: Designing ML Data Architectures for Physical AI

An Phan

Senior Data Infrastructure Engineer @ Hippo Harvest

An Phan
Open session

World Congress 2026 North America

September 24, 2026 · 17:30–18:00

Stage 6

No Single Model to Rule Them All: Building Resilient AI Agents Across Open & Closed LLMs

Emmanuel Acheampong

Senior Manager Developer Relations at Crusoe AI

Emmanuel Acheampong
Open session

World Congress 2026 North America

September 25, 2026 · 15:45–15:55

Outdoor Stage

Closing the Visibility Gap: Lessons from Safety Critical Agentic Systems

Vivek Pandit

Frontier AI Lead at Turing

Vivek Pandit
Open session

World Congress 2026 North America

September 25, 2026 · 11:40–12:10

Stage 2

Reinventing Testing Practices in the AI Era

Eric Deandrea

Java Champion & Senior Principal Software Engineer, IBM

Eric Deandrea